[옵티마이저]
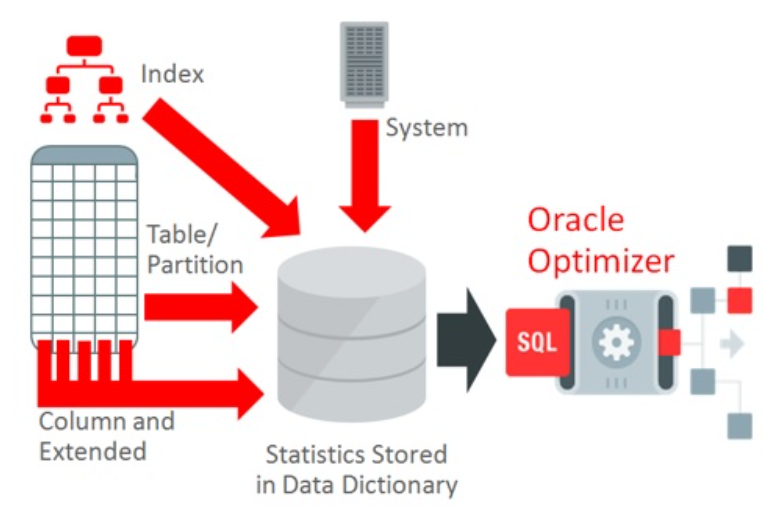
- 사용자가 원하는 작업을 가장 효율적으로 수행할 수 있는 최적의 데이터 액세스 경로를 선택해주는 DBMS의 핵심 엔진
- 옵티마이저의 판단이 항상 최선은 아니기 때문에, 튜너는 실행 계획을 분석하여 힌트를 적용하거나 SQL 구조를 변경하는 방식으로 성능 최적화 필요
[옵티마이저 종류]
1) RBO (Rule Based Optimizer)
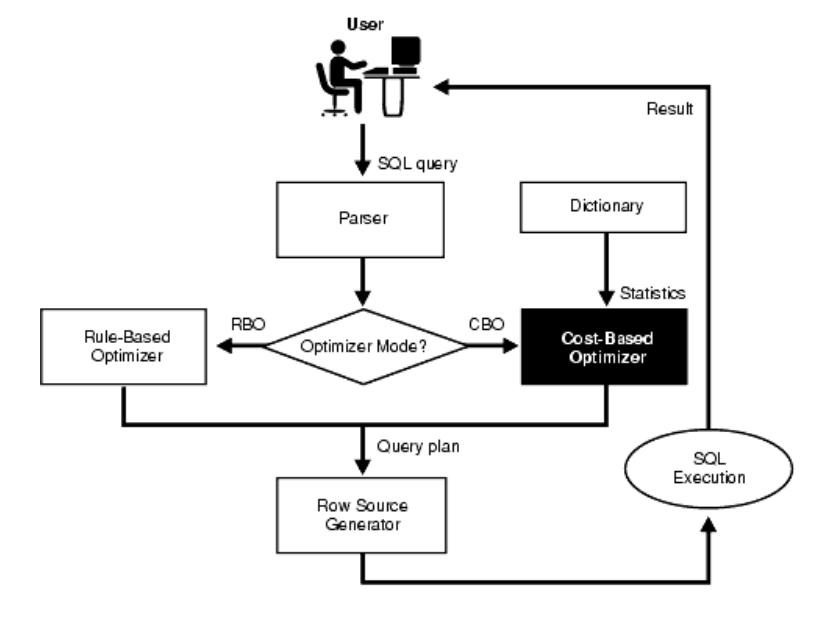
- 데이터 양이나 분포도를 고려하지 않고, 오직 고정된 우선순위 규칙(인덱스 유무, 연산자 등) 기준으로 경로 선택
- 조건이 여러 개일 때 규칙 우선순위만 따르므로 비효율적
(EX) 'Deptno = 10 AND Sal > 4000' 일 때, '=' 연산자 우선순위가 더 높기 때문에 Sal 인덱스는 무시됨
- 현재는 사용되지 않으며, 강제 적용시 /*+ RULE */ 힌트를 사용해야 함
2) CBO (Cost Based Optimizer)
- Oracle 10g 부터는 기본적으로 CBO가 사용되며, Data Dictionary 통계정보를 바탕으로 가장 적은 비용의 경로를 선택
(EX) 사원 1000명 중 관리자가 800명 (80%)일 경우, 인덱스가 있어도 Full Table Scan
→ Table과 Index는 서로 다른 Segment이며, 물리적으로 다른 Data File에 존재할 수 있기 때문에, 훨씬 많은 디스크 I/O 유발할 가능성 존재
[ CBO Optimizer 구성 요소]
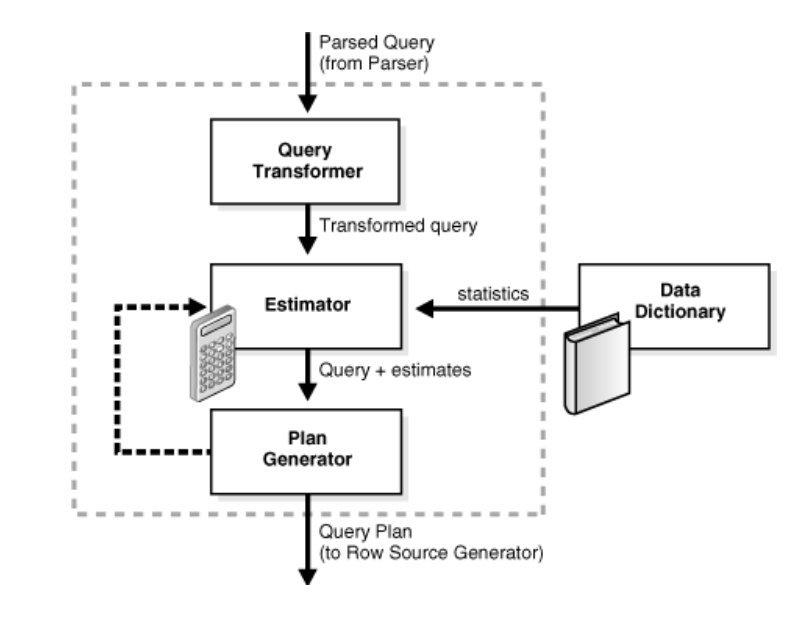
CBO는 내부적으로 총 3가지 모듈을 거쳐 최적의 경로를 수립함 (이 과정은 고정 규칙만 따르는 RBO에는 존재 X)
1) Query Tranformer
- 사용자가 작성한 SQL을 분석하여, 구조를 변경했을 때 더 효율적인 실행 계획을 수립할 수 있다고 판단되면 SQL을 내부적으로 재작성(Rewriting)하는 모듈
① View Merging
: 인라인 뷰나 View의 구조를 외부 메인 쿼리 블록과 하나로 합쳐서 최적화 대상 범위를 넓힘
② Subquery Unnesting
: 중첩된 서브쿼리를 일반 조인문이나 세미 조인(Semi Join) 형태로 풀어헤쳐 더 효율적인 조인 방식을 선택할 수 있게 함
2) Estimator
- 수정된 쿼리 후보들을 대상으로 데이터 사전의 통계정보를 기반으로 계산하여 각 실행 계획의 전체 비용을 결정하는 모듈
- 아래 5가지 단계를 거치는 프로세스로 연산이 수행됨
3) Plan Generator
- Estimator가 비용을 계산한 후보 실행 계획들 중, 가장 비용이 낮은 계획을 최종 실행 계획으로 선택하는 모듈
[Estimator 상세 프로세스]
1) Optimizer Statistics
- Object 통계 + System 통계 정보이며, Cost 계산의 기초가 되는 데이터
- 자동 통계 수집은 실시간이 아닌 밤에 돌기 때문에, 대량의 데이터를 변경하여 통계정보 변경이 필요한 경우에는 DBMS_STATS.GATHER_TABLE_STATS 를 이용해 수동으로 수집 필요
- 관련 지표
① Num_Rows : 테이블에 존재하는 전체 데이터 건수
② NDV (Number of Distinct Values) : 컬럼 내 중복없는 고유한 값의 종류 수
2) 데이터 분포 판단
- 균등 분산 가정(Uniform Distribution) : 기본적으로 모든 데이터가 1/NDV 비율로 전 구간에 똑같이 퍼져있다고 가정
- Histogram : 데이터 편향이 심할 경우는 히스토그램을 Estimator에게 강제로 주입해야 함
→ 단, 모든 컬럼에 만들면 부하가 가중되므로 오라클이 판단하여 자동 생성하게 하는 method_opt => 'for all columns size auto' 옵션이 권장됨
3) Selectivity (선택성)
- 조건절에 의해 선택될 것으로 예상되는 행의 비율 (0.0 ~1.0)
- (조건을 만족하는 행 수) / (총 행 수)
- 값이 낮을수록(적은 로우만 남길수록) 많은 행을 걸러내므로 인덱스 스캔에 유리
4) Cardinality (카디널리티)
- 각 연산 단계에서 출력될 것으로 예상되는 결과 행 수 (Execution plan의 Rows 항목에 찍히는 수치)
- (총 행 수) * Selectivity
5) Cost (비용)
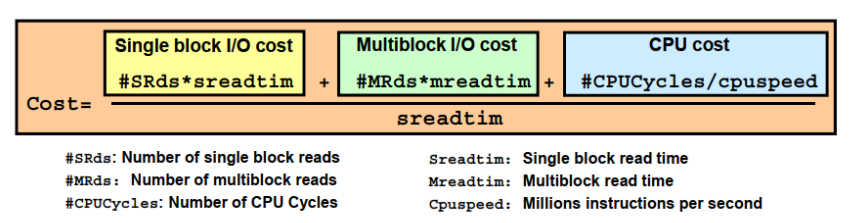
- 예측한 명령어를 실행하는 데 필요한 표준화된 예상 디스크 I/O 횟수 및 CPU 사용량 (단위 : 1 SRds)
- ((단일 블록 I/O 비용 + 다중 블록 I/O 비용 + CPU 연산 비용) / Sreadtim)
→ 최종 연산 값은 '단일 블록 몇 번을 읽어야 작업을 완료할 수 있는지'를 의미함
→ Cost가 1,000이면 단일 블록 읽기를 1,000번 수행한 시간만큼 걸린다고 예측한 것
'IT' 카테고리의 다른 글
| [Oracle] SQL튜닝 - 4: INDEX (0) | 2026.06.09 |
|---|---|
| [Oracle] SQL튜닝 - 3: Execution Plan (0) | 2026.06.03 |
| [Oracle] SQL튜닝 - 1: SQL 처리 절차 (0) | 2026.05.31 |
| [Oracle] Oracle Database Server Architecture - 3: 메모리영역 (0) | 2026.05.31 |
| [Oracle] Oracle Database Server Architecture - 2: 디스크영역 (0) | 2026.05.31 |